
دادههای ساختاریافته زمانی بیشترین کارایی را خواهند داشت که موجودیتها را کاملا منسجم به یکدیگر مرتبط کنند، از شناسههای پایدار و یکسان استفاده نمایند و با محتوای قابل مشاهده صفحه و دیگر منابع معتبر هماهنگ بمانند. این دادهها برای سالها یکی از اجزای مهم سئوی فنی به شمار میروند و به موتورهای جستوجو کمک میکنند محتوای صفحات را با قالبی استانداردتر تفسیر و دستهبندی نمایند. با گسترش جستجوی هوش مصنوعی، صرفا افزودن اسکیما مارکآپ برای پوشش سئوی فنی کافی نیست و برخی خطاهای رایج میتوانند کیفیت درک سامانههای جستوجو و بازیابی اطلاعات را کاهش دهند.
مسئله اصلی فقط تعداد یا تنوع Schema نیست، بلکه کیفیت ارتباط میان دادهها، تازگی اطلاعات و هماهنگی آنها با محتوای واقعی نیز اهمیت پیدا میکند. هرچه اطلاعات یک وبسایت از نظر هویت موجودیتها و روابط میان آنها منسجمتر ارائه شوند، تفسیر آنها نیز ساختارمندتر میشود. در عین حال، این انسجام زمانی ارزشمند خواهد بود که دادهها دقیق، قابل تأیید و در نقاط مختلف وبسایت یکدست باقی بمانند. این مقاله برداشتهای نادرست و خطاهای رایج در استفاده از دادههای ساختاریافته را بررسی میکند.
تصویر(1)
برخورد با دادههای ساختاریافته بهعنوان یک چکلیست
یکی از خطاهای رایج این است که اسکیما مارکآپ فقط بهعنوان فهرستی از انواع نشانهگذاریها در نظر گرفته شود که باید روی هر صفحه اجرا گردد، بدون آنکه هدف و روابط میان موجودیتها در ساختاری بزرگتر تعریف شوند. در این رویکرد، متخصصان سئو معمولاً نوع اصلی صفحه، مانند Article یا Product، را مشخص میکنند تا موتور جستوجو بتواند ماهیت و ویژگیهای محتوا را تشخیص دهد.
بااینحال، در محیط جستجوی هوش مصنوعی، تنها تعیین نوع محتوا کافی نخواهد بود و باید هویت موجودیتها و روابط میان آنها نیز روشن گردد. دادههای ساختاریافته بهتنهایی تضمین نمیکنند که سامانه هوش مصنوعی حتماً یک صفحه را بهعنوان منبع اصلی پاسخ انتخاب کند اما میتوانند اطلاعات یک وبسایت را به شکلی استاندارد توصیف نمایند. بنابراین، راهبرد درست باید به این پرسش پاسخ دهد که آیا Schema تشخیص هویت موجودیتها و ارتباط میان اطلاعات صفحه را برای ماشینها آسانتر میکند یا خیر.
در عمل، مقاله یا صفحه محصول نباید صرفا یک نوع Schema داشته باشند، بلکه باید بتوانند ارتباط خود را با موجودیتهای مرتبط مانند نویسنده، سازمان، برند، محصول یا صفحه معرفی نویسنده نشان دهند. برای نمونه، یک مقاله وبلاگ میتواند با Article نشانهگذاری شود اما در پیادهسازی کاملتر، author به یک موجودیت Person یا Organization و publisher با موجودیت Organization مرتبط گردد. این ارتباطها به ایجاد یک گراف معنایی منسجمتر کمک میکنند و روابط میان اجزای مختلف محتوا را برای سامانههای پردازش اطلاعات شفافتر میسازند.
صرفا اتکا بر دادههای ساختاریافته برای شفافسازی موجودیتها
استفاده راهبردی از دادههای ساختاریافته فقط به مشخص کردن نوع اطلاعات صفحه محدود نمیشود و اطلاعات نشانهگذاریشده باید با محتوای واقعی صفحه و منابع معتبر دیگر سازگار بمانند. قرار گرفتن اطلاعات در اسکیما مارکآپ بهخودیخود باعث نمیشود تمام سامانهها آن اطلاعات را معتبرترین داده درباره یک موجودیت تلقی کنند.
تصویر(2)
به همین دلیل، مدیریت موجودیتها باید فراتر از خود وبسایت دنبال شود و ثبات اطلاعات در سراسر وب نیز حفظ گردد. اگر منابع معتبر نام قدیمی برند، نشانی قبلی شرکت یا قیمت قدیمی محصول را نمایش دهند، اصلاح Schema وبسایت بهتنهایی تمام ناهماهنگیها را برطرف نمیکند. برای نمونه، اگر وبسایت رسمی نام جدید برند را ثبت نماید اما سایتهای دیگر همچنان نام قدیمی را نمایش دهند، نشانهگذاری صحیح در وبسایت رسمی لازم خواهد بود اما شکلگیری درک منسجم از هویت برند به ثبات اطلاعات در منابع مختلف نیز وابسته است. بنابراین، دادههای ساختاریافته باید بخشی از یک راهبرد گستردهتر برای مدیریت و یکپارچهسازی اطلاعات موجودیتها در وب تلقی شوند.
عدم استفاده از شناسههای یکسان برای موجودیتها
یکی از روشهای مهم برای ایجاد ارتباط پایدار میان موجودیتها، به کار بردن شناسههای یکسان مانند id@ است. این شناسهها باعث میشوند نشانهگذاریهای مختلف بتوانند به یک موجودیت مشخص اشاره کنند و سامانهها ارتباط میان دادههای صفحات مختلف را بهتر تشخیص دهند.
برای مثال، وبسایت سازمان میتواند یک id@ پایدار مانند https://www.example.com/#organization داشته باشد. در صفحات دیگر، بهجای آنکه مشخصات سازمان دوباره کاملا تعریف شوند، میتوان همان شناسه را در ویژگیهایی مانند publisher به کار برد. در نتیجه، مقاله و سازمان کاملا شفاف به یکدیگر مرتبط میشوند و ساختار معنایی وبسایت منسجمتر خواهد شد.
مزیت مهم id@ در این است که احتمال ایجاد شناسههای متفاوت برای یک موجودیت واحد را کاهش میدهد و ارتباط میان نشانهگذاریهای گوناگون را سادهتر میکند. بااینحال، id@ یک سامانه همگامسازی خودکار محسوب نمیشود و تغییر اطلاعات هر موجودیت، دادههای مشابه را در صفحات دیگر بهصورت خودکار اصلاح نمیکند.
برای نمونه، ممکن است اسکیمای قدیمی یک سازمان نام «example’s Shop» را داشته باشد، در حالی که صفحات جدید از نام «example’s Ecommerce Store» استفاده کنند. در چنین وضعیتی، یک id@ مشترک کمک خواهد کرد تا نشانهگذاریها به یک موجودیت مرتبط شوند اما خود شناسه تناقض میان مقادیر name را برطرف نمیکند. بنابراین، استفاده از شناسه پایدار باید با فرایند مشخصی برای نگهداری، بازبینی و یکپارچهسازی دادهها همراه شود.
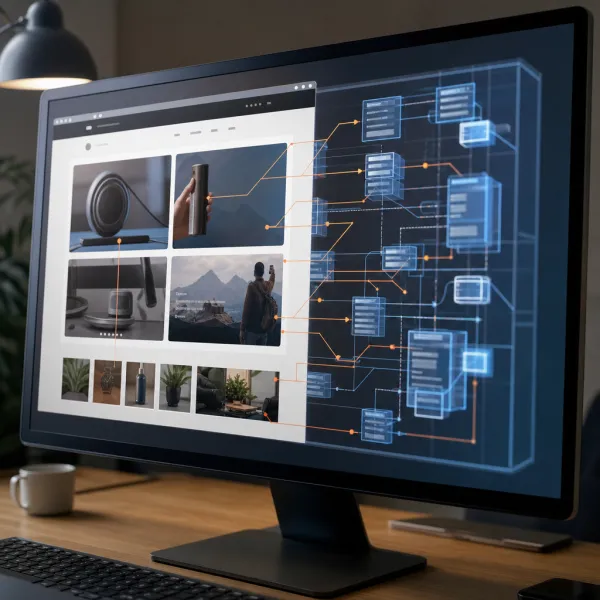
تصویر(3)
استفاده از اسکیمای معتبر که محتوای قابل مشاهده صفحه را بهدرستی نشان نمیدهد
یکی دیگر از خطاهای مهم، به کار بردن دادههای ساختاریافتهای است که با محتوای قابل مشاهده صفحه مطابقت ندارند. دادههای Schema باید اطلاعاتی را ارائه کنند که در صفحه برای کاربر قابل مشاهده یا قابل تأیید هستند زیرا نشانهگذاری گمراهکننده میتواند با دستورالعملهای موتورهای جستوجو ناسازگار شود.
برای نمونه، فرض کنید صفحه یک دستگاه قهوهساز قیمت ۷۹٫۹۹ پوند و وضعیت موجودی را نمایش دهد و هیچ امتیاز یا نقد و بررسی مشتری در آن دیده نشود. اگر اسکیمای همان صفحه مقدار ratingValue را برابر ۴٫۹ و reviewCount را معادل ۱۲۷ ثبت کند، میان محتوای قابل مشاهده و دادههای ساختاریافته تعارض ایجاد میشود. این ناهماهنگی میتواند کیفیت تفسیر صفحه را کاهش دهد و در صورت نقض دستورالعملها باعث نادیده گرفته شدن دادههای ساختاریافته در نتایج غنی (Rich Results) شود.
بنابراین، دادههای ساختاریافته باید بازتاب دقیق محتوایی باشند که صفحه واقعاً ارائه میکند و نباید اطلاعاتی را اعلام کنند که کاربر امکان مشاهده یا تأیید آنها را در صفحه نداشته باشد.
قدیمی شدن دادههای ساختاریافته یا ایجاد تعارض آنها با منابع دیگر
قدیمی شدن اسکیما مارکآپ نیز از خطاهای رایج به شمار میرود و زمانی رخ میدهد که اطلاعات نشانهگذاریشده پس از تغییر صفحه یا دادههای کسبوکار بروزرسانی نشوند. برای نمونه، ممکن است اسکیما موجود بودن محصول را نشان دهد اما در صفحه محصول وضعیت ناموجود باشد.
تصویر(4)
این تعارض باعث میشود سامانههای پردازش و بازیابی اطلاعات با دو مقدار متفاوت برای یک واقعیت مشخص مواجه شوند و تفسیر وضعیت واقعی محصول دشوارتر گردد. اختلاف قیمت نمونه روشنی از این مشکل به شمار میرود. اگر صفحه قیمت ۷۹٫۹۹ پوند را نمایش دهد اما Schema قیمت ۵۹٫۹۹ پوند را ثبت کند، دو مقدار متفاوت برای یک ویژگی واحد ارائه می شود. این ناهماهنگی میتواند به سردرگمی جهت پردازش اطلاعات، آسیب دیدن تجربه کاربر و در صورت مغایرت با دستورالعملها، موجب اقدام دستی شود.
به همین دلیل، نگهداری دادههای ساختاریافته باید بخشی از فرایند مدیریت محتوا باشد و هر تغییر مهم روی قیمت، موجودی، امتیاز، نام برند یا اطلاعات سازمان باید در Schema نیز بازتاب پیدا کند. هدف آن است که دادههای نشانهگذاریشده در هر زمان، تصویری تازه و سازگار از اطلاعات واقعی صفحه ارائه کنند.
جمعبندی
در این چارچوب، بررسی دادههای ساختاریافته نباید فقط هنگام انتشار صفحه انجام شود و باید بهصورت دورهای نیز تکرار گردد. هر تغییر در ساختار محتوا، اطلاعات سازمان، محصول یا ارتباط میان نویسنده و ناشر میتواند نیاز به بازبینی Schema ایجاد کند. همچنین، هماهنگی میان صفحات و حفظ ثبات هویت و ویژگیهای موجودیتها اهمیت دارد. دادههای ساختاریافته به موتورهای جستوجو و سامانههای پردازش اطلاعات کمک میکنند تا محتوا را دقیقتر درک نمایند اما افزودن Schema بهتنهایی تضمینی برای دیدهشدن بیشتر نیست.